Сайт с помощью Claude: как я собрал его без программиста и попал в ответы ChatGPT
Весь код dovydov.pro написал Claude: сборщик, шаблоны, обложки, схемы, RSS для Дзена и разметку для нейросетей. Я не программист, и до 18 сентября на моём маке даже не было Node.js. Как устроена работа, что сделано ради выдачи в нейросетях и как сайт появился в ответах ChatGPT.
Да, сайт можно сделать с помощью Claude без программиста: dovydov.pro целиком написан им, от сборщика на Node.js без внешних библиотек до генераторов обложек и инфографики. С 9 сентября по 3 ноября 2026 года на сайте вышло 39 разборов. Чтобы сайт находили нейросети, у каждой статьи есть блок «Коротко», который уходит в разметку Schema.org и в файл llms.txt, а robots.txt поимённо открывает сайт 13 роботам языковых моделей, в том числе GPTBot и OAI-SearchBot. С 22 октября по 3 ноября из ответов ChatGPT на сайт и индекс карт пришло 18 визитов: Метрика видит их по метке utm_source=chatgpt.com, которую ChatGPT сам дописывает к ссылкам.
Ни одной строчки кода на dovydov.pro я не написал сам. Сборщик сайта, шаблоны страниц, генераторы обложек и схем, скрипт заливки на хостинг сделал Claude, а я ставил задачи и проверял, что получилось. Первый разбор вышел 9 сентября 2026 года, к 3 ноября их 39. Рядом живёт поддомен karty.dovydov.pro с индексом зарубежных карт и 26 страницами обзоров и инструкций, его тоже собрал Claude.
С самого начала у сайта была одна главная задача: чтобы меня цитировали нейросети. Про санкции, карты и крипту теперь спрашивают и у ChatGPT с Алисой, и мне важно попадать в эти ответы. Поэтому половина того, что Claude сделал на сайте, читателю не видна: она для роботов.
Можно ли сделать сайт с помощью Claude без программиста?
Можно, если вас устраивает сайт на коде без конструктора. Конструктор вроде Tilda я брать не стал: сайт написан кодом и лежит на обычном хостинге. Правка разметки или служебного файла для нейросетей в коде делается один раз и сразу расходится по всем страницам. Ориентиром по структуре взял pershikov.pro. Стиль выбирал из нескольких вариантов и остановился на светлой редакционной вёрстке с заголовками шрифтом Unbounded и лаймовыми акцентами.
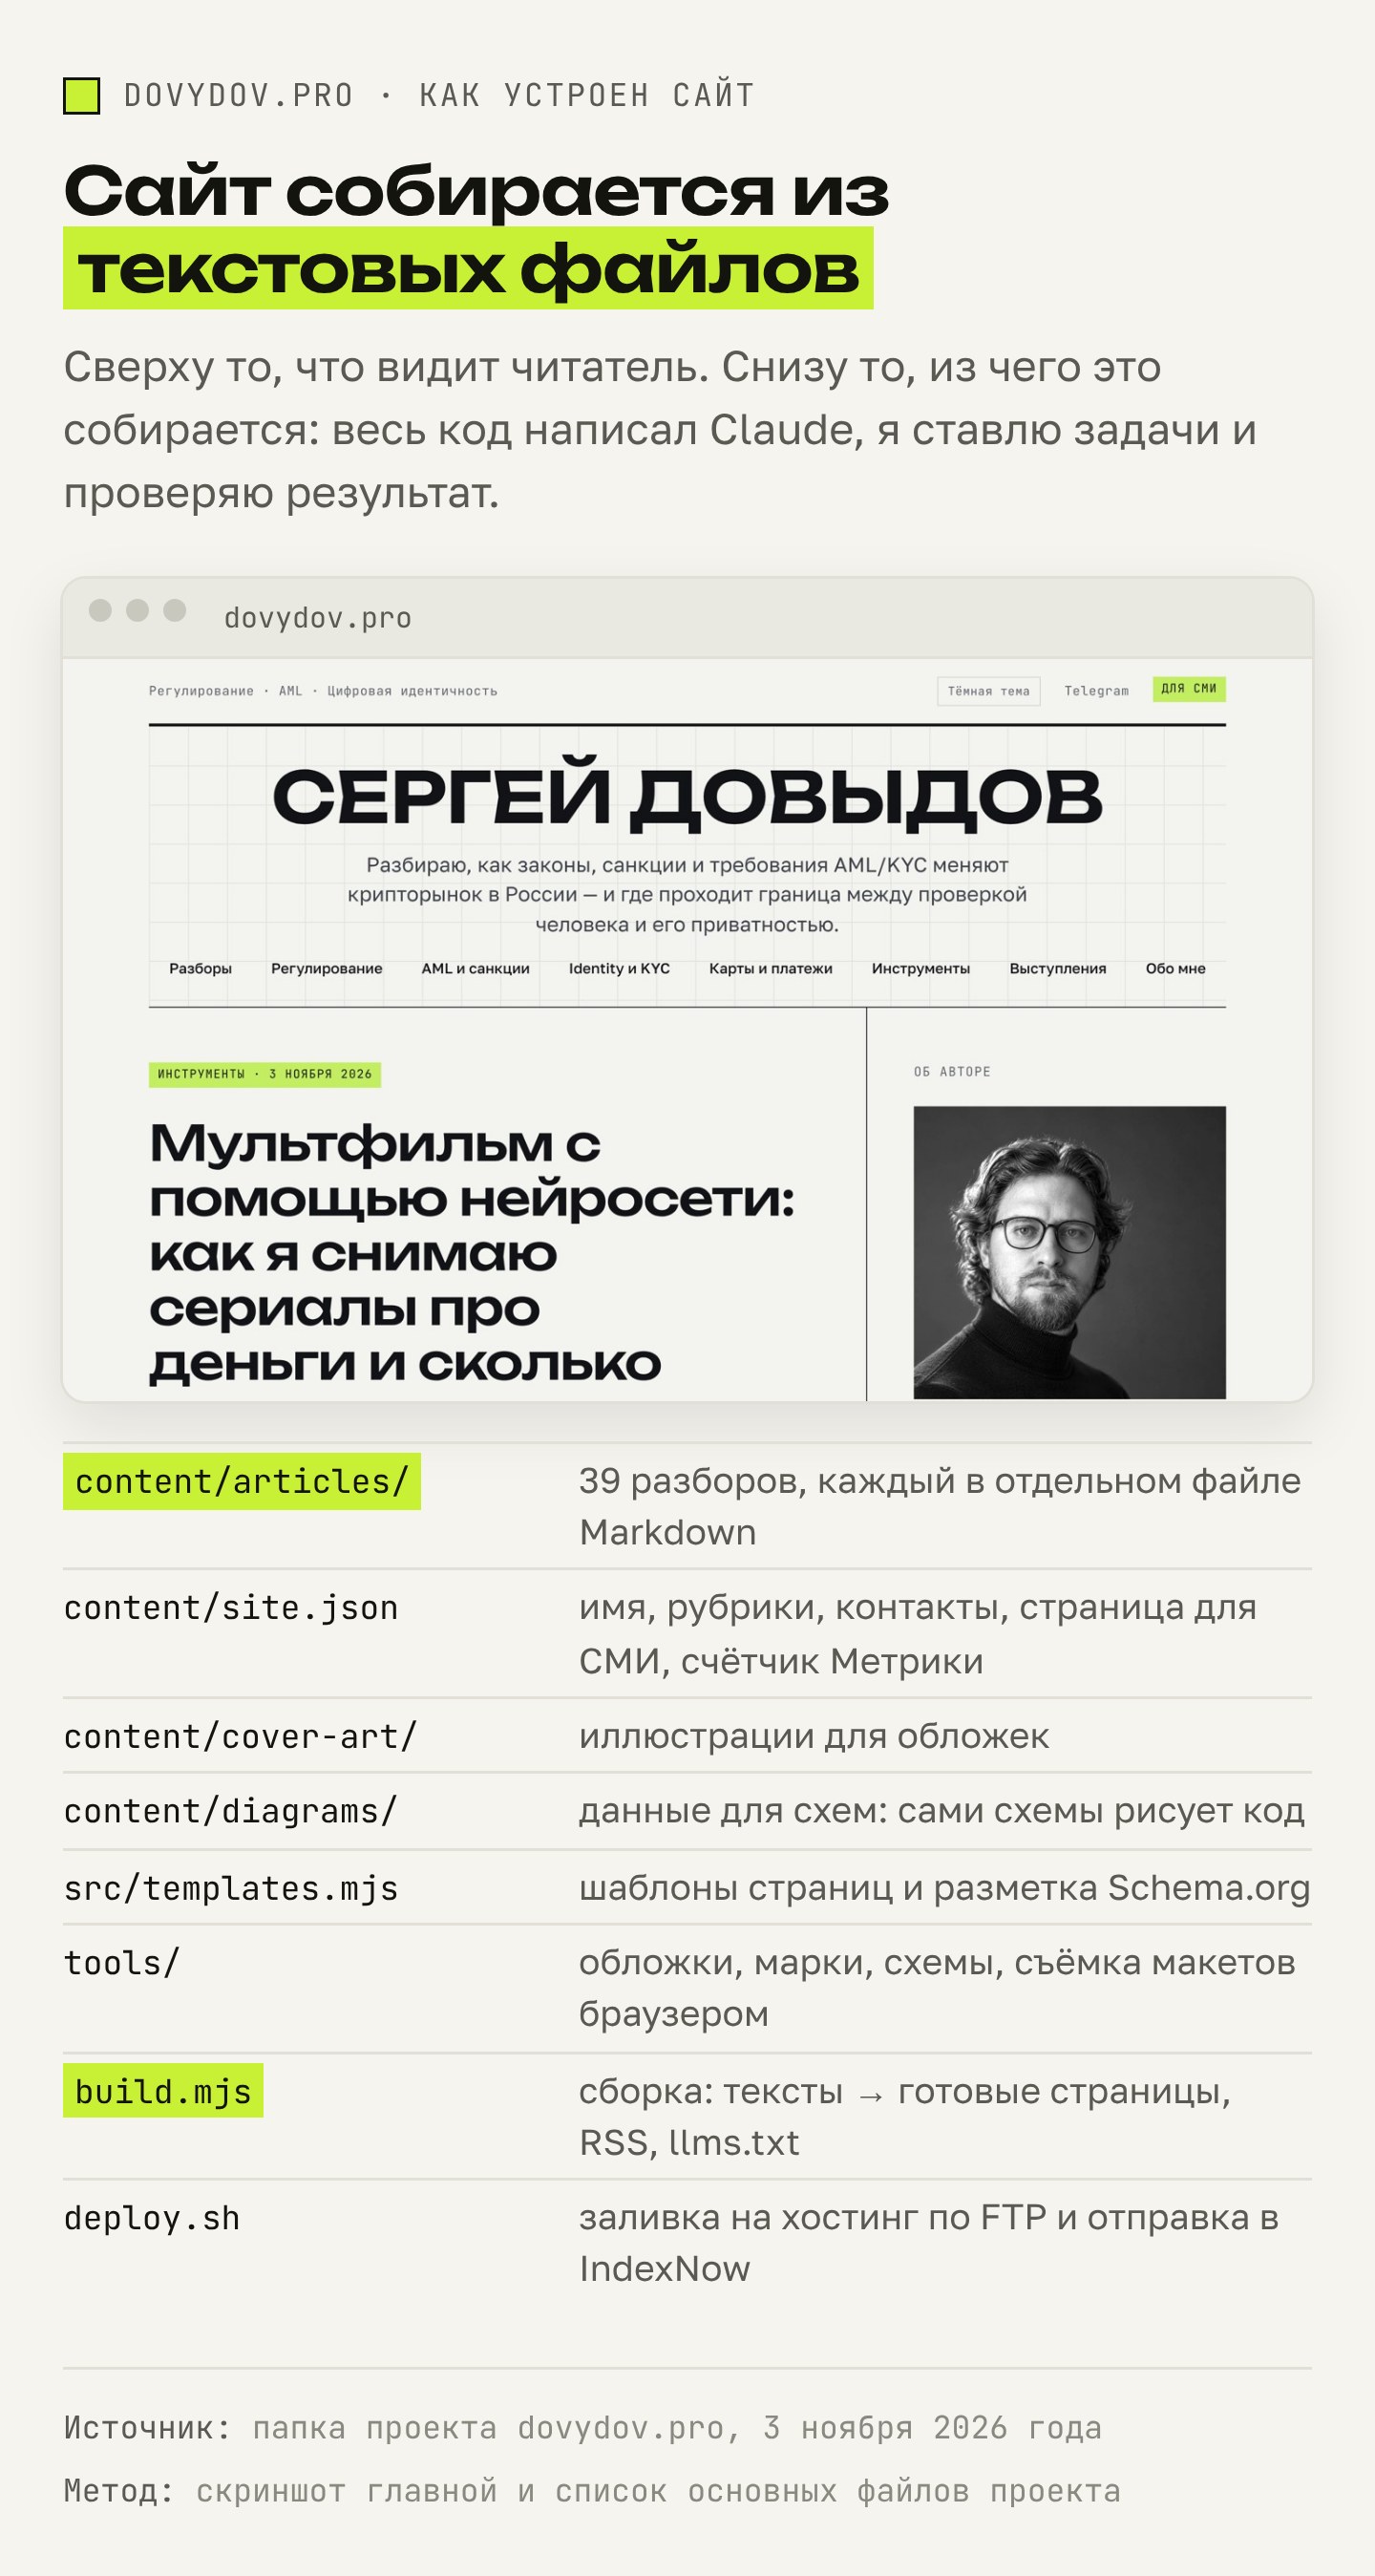
Сайт статический. Сборщик Claude написал без сторонних зависимостей, ему нужен только Node.js. Тексты лежат в файлах Markdown, настройки сайта в одном site.json, команда сборки превращает это в готовые страницы. До 18 сентября Node.js у меня на маке не было вообще. Сборку делал Claude у себя, а я запускал заливку двойным кликом.
С хостингом пришлось повозиться. Netlify отпал: его адреса блокируются у российских провайдеров. Cloudflare тоже не подошёл, у части пользователей из России сайты за ним периодически не открываются. В итоге сайт живёт на Рег.ру, а обновление уходит по FTP одним скриптом deploy.sh.
Что Claude сделал на сайте, кроме самих страниц?
Больше всего работы оказалось вокруг статей. Обложки, схемы, картинки для карточек и постов в Telegram собираются как макеты и снимаются браузером, поэтому шрифты и цвета везде одинаковые, и поправить подпись можно за минуту.
| Задача | Как сделано |
|---|---|
| Обложки статей | макет 1600×900, слева заголовок, справа иллюстрация-сюжет |
| Схемы и инфографика | в стиле журнала «ПЛАС», макет 480 px, съёмка с тройным увеличением; на сайте их больше 70 |
| Картинки для карточек | отдельные «марки» 1200×675 без текста, чтобы не повторять заголовок |
| Обложки постов в Telegram | 1600×900, отдельные шаблоны для разбора, недельного выпуска и поста-тезиса |
| Медиа-кит для журналистов | 4 страницы A4, собираются из того же site.json, что и сайт |
| Лента для Дзена | RSS, из которого вычищены теги, которые Дзен не принимает |
| Отложенный выход | статья с будущей датой появляется сама при пересборке, дата считается по Москве |
| «Читайте также» | похожие разборы подбираются по ссылкам между статьями, рубрике, словам в заголовке и подзаголовке |
Многое из этого появилось после конкретной ошибки. Однажды упал локальный сервер, и в папку картинок уехали снимки страницы ошибки Chrome. После этого скрипт съёмки падает на любом ответе, кроме нормального. В другой раз картинка для карточки нового разбора не попала на сайт из-за пропущенной строчки в настройках, и сборка теперь предупреждает о таких файлах. Claude оставляет в коде комментарии с причиной таких правок, и через месяц по ним понятно, откуда что взялось.
Как я работаю с Claude над статьями?
Вся работа идёт в проекте Claude «мой сайт». Там почти сотня документов: журнал SEO-правок, журнал индексации, планы, сценарии роликов, разборы аналитики. Плюс память, в которой записаны мои правила. Например, H1 начинается с того, как люди ищут тему, а блок «Коротко» начинается с прямого ответа. Отдельный список касается вычитки: фразы, по которым сразу видно нейросетевой текст, Claude ищет и убирает до того, как показать мне черновик.
Типичный путь разбора такой:
- Тема приходит из мониторинга новостей регуляторов и отраслевых СМИ.
- Claude находит первоисточники и сверяет каждую цифру и дату.
- Черновик пишется сразу в файл статьи со всеми служебными полями.
- Вычитка на нейросетевые приёмы и самоповторы с прошлыми статьями.
- Обложка с иллюстрацией и одна-две инфографики, если в материале есть числа.
- Сборка, заливка на хостинг, Дзен забирает статью из RSS сам.
Тему и выводы выбираю я, финальная правка тоже моя. Если факт не нашёлся в открытых источниках, в текст он не идёт, пока я не пришлю скриншот.
Так же через Claude я делаю ролики и мультфильмы в Higgsfield: у сервиса есть коннектор, и Claude сам запускает генерации.
Что такое llms.txt и зачем он сайту?
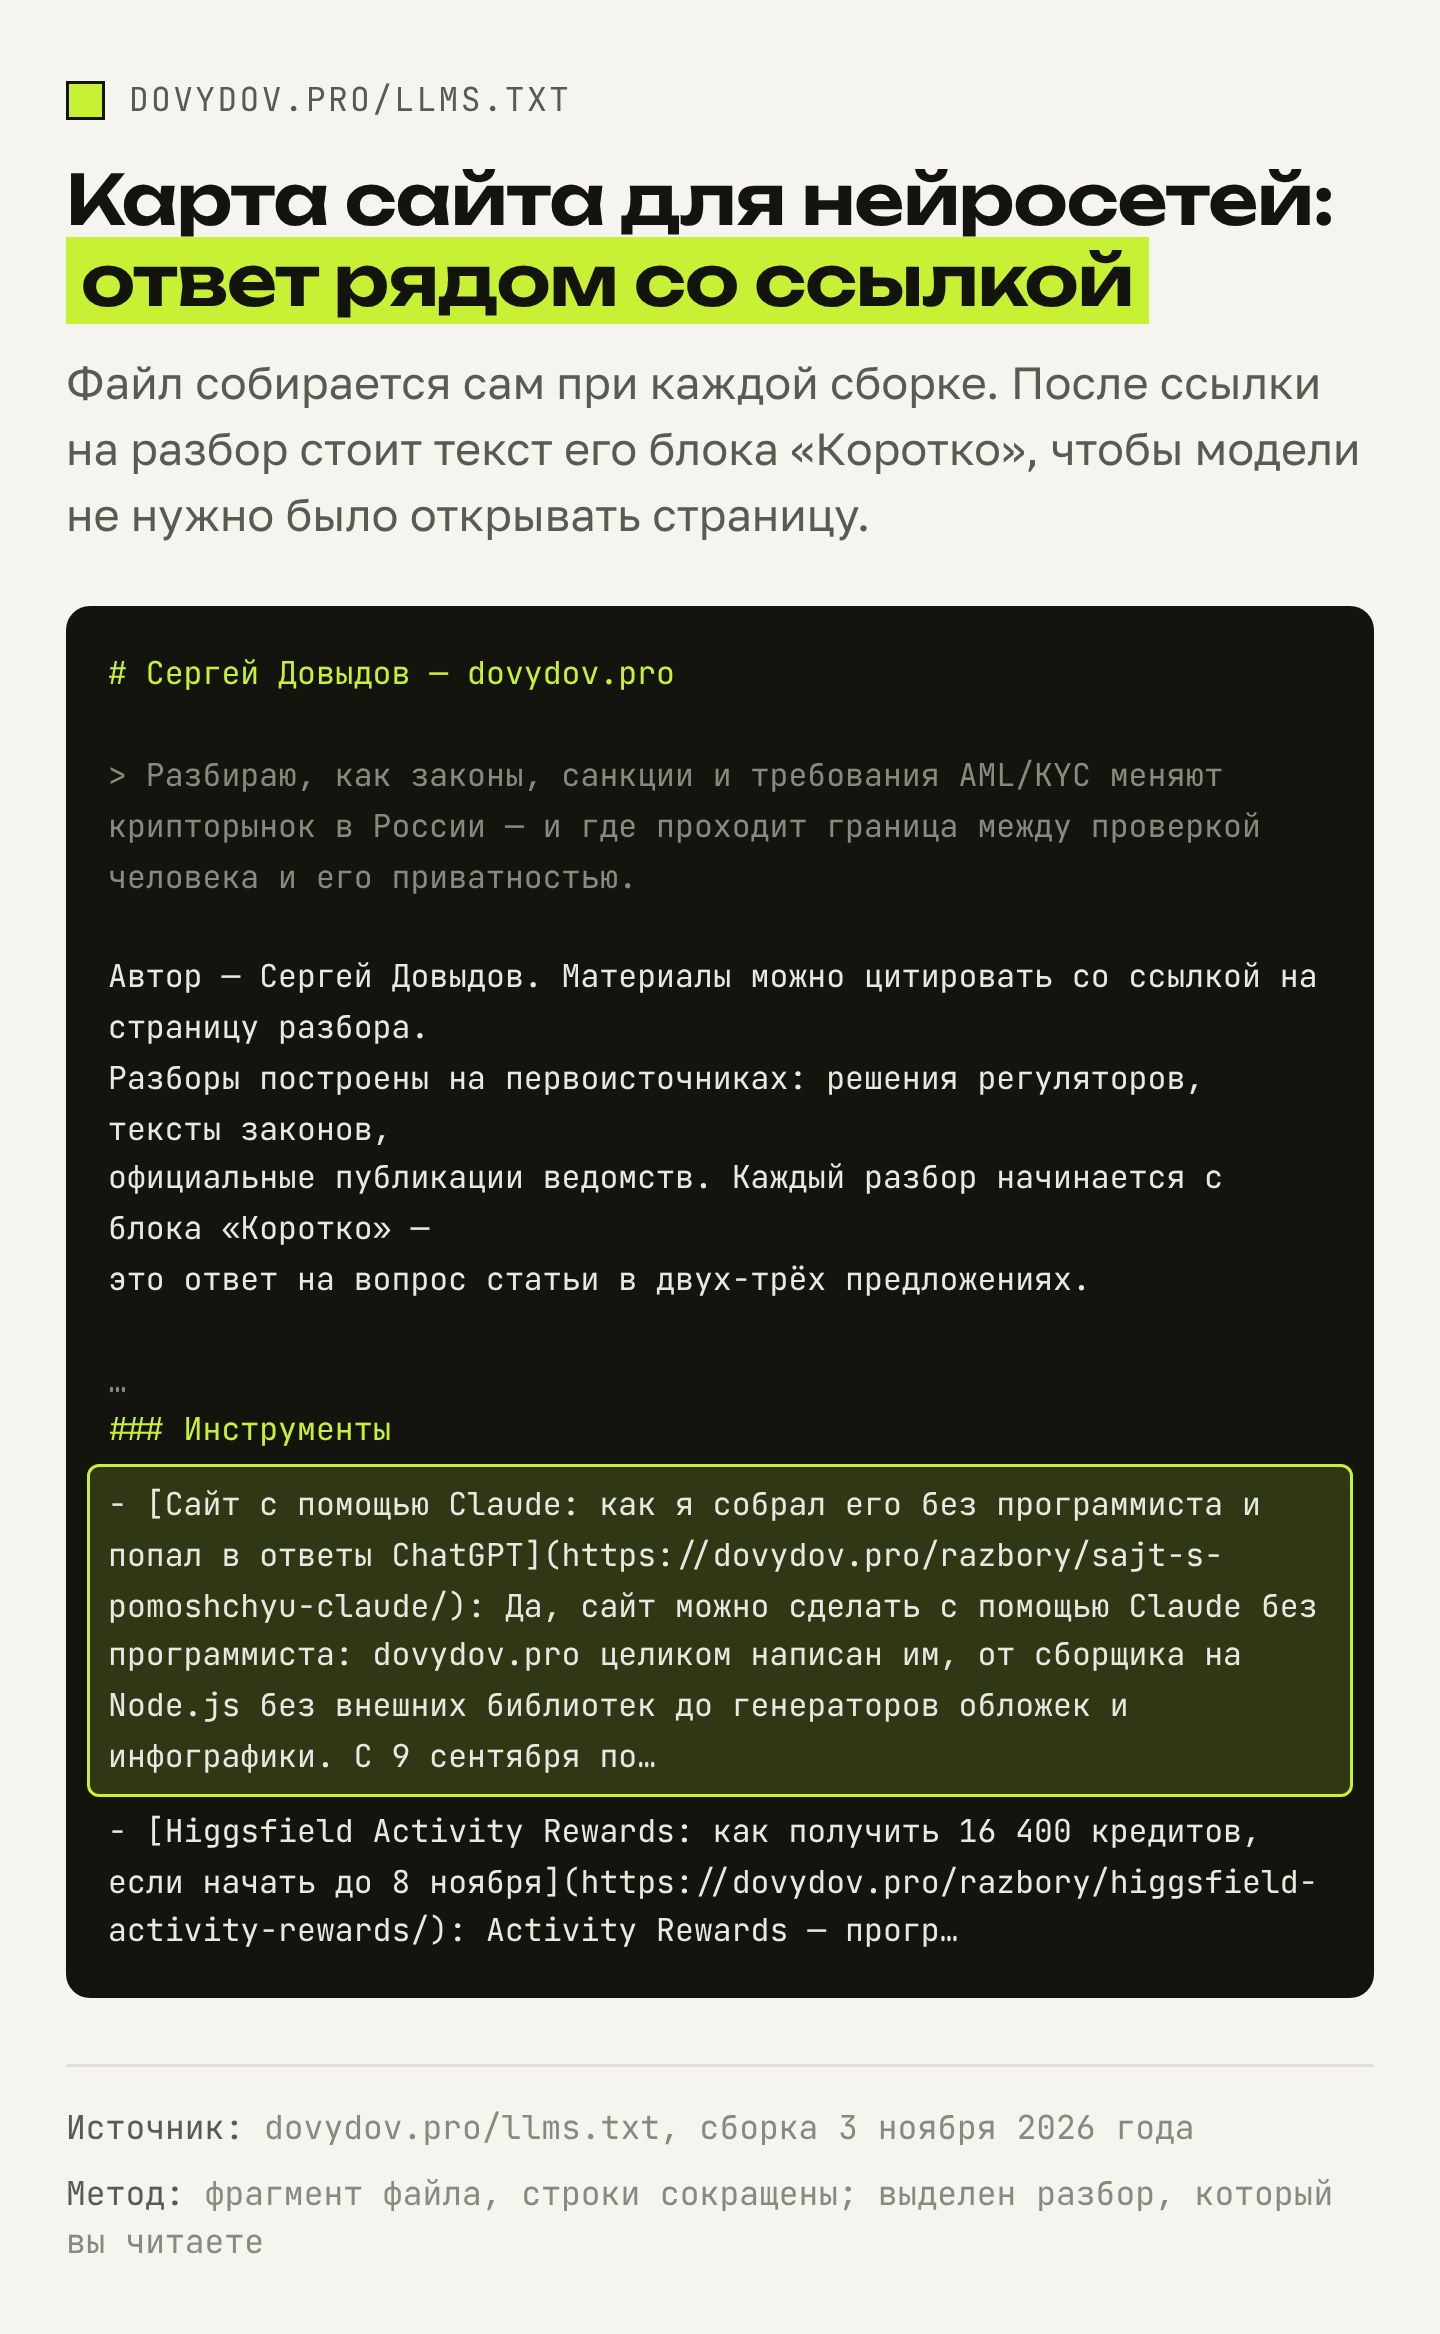
llms.txt лежит в корне сайта и выглядит как короткая карта сайта в Markdown для языковых моделей. Стандарт пока складывается, но идея простая: отдать модели суть текстом, чтобы ей не пришлось разбирать вёрстку. Робот открывает dovydov.pro/llms.txt и сразу видит автора, тему сайта, список разборов с короткими ответами и главные страницы.
У меня этот файл собирается автоматически при каждой сборке. В нём все опубликованные разборы по рубрикам, на 3 ноября их 39, и у каждого рядом с заголовком стоит текст блока «Коротко». Черновики и закрытые страницы туда не попадают. В конце файла ссылка на отдельный llms.txt поддомена с индексом карт.
Проверить, читают ли его роботы ChatGPT или Алисы, я со своей стороны не могу. Мне он обошёлся в одну функцию в коде, так что держать его есть смысл.
Какую разметку Schema.org видят ChatGPT и поисковики?
На каждой странице есть блок JSON-LD с разметкой Schema.org. Он описывает меня как человека (Person) с темами экспертизы и ссылками на мои каналы, а каждый разбор как статью (Article) с автором и датами публикации и обновления. Текст «Коротко» уходит в поле abstract. Раздел «Частые вопросы» в конце статьи сборка сама превращает в разметку FAQPage: каждый вопрос третьего уровня становится вопросом, текст под ним ответом. Ещё есть хлебные крошки и разметка видео там, где в статье ролик.
Отсюда правила, которые видны в самих текстах. Первое предложение «Коротко» отвечает на вопрос статьи, потому что модель цитирует именно его. Заголовки разделов звучат как вопросы, которые человек задаёт поиску или чат-боту. Название закона, сервиса или термина обязательно стоит в одном из заголовков: модель ищет сущность, и если её нет в заголовках, статья для неё как будто про другое.
Каким роботам ChatGPT, Claude и Яндекса открыт сайт?
В robots.txt сайт открыт всем, но 13 роботов языковых моделей перечислены по именам: GPTBot, OAI-SearchBot и ChatGPT-User от OpenAI, ClaudeBot и два других робота Anthropic, два робота Perplexity, Google-Extended, Applebot-Extended, CCBot и два правила Яндекса. YandexAdditional отвечает за быстрые ответы с YandexGPT в Нейро и ответы Поиска с Алисой. Общее правило их и так пропускает, но краулеры ищут в файле своё имя.
Один robots.txt ещё ничего не гарантирует. 16 октября Claude проверил, что роботы получают в ответ от сервера: поисковые роботы ChatGPT, Claude и Perplexity получали страницы нормально, а GPTBot и ClaudeBot, которые собирают тексты для обучения моделей, натыкались на ошибку 502 от защиты хостинга. Значит, цитировать сайт в поиске модели могут, а в обучающие выборки он не попадает, пока хостинг не снимет блокировку.
На поддомене с индексом карт таблица дублируется прямо в HTML. Робот, который не исполняет скрипты, всё равно видит все карты и цены.
При каждой заливке скрипт отправляет новые и изменённые страницы через IndexNow, чтобы Яндекс и Bing приходили за ними сразу. Сайт подтверждён в Яндекс.Вебмастере и Google Search Console, а раз в неделю Claude проверяет, что из этого дошло до индекса.
Начинал я с нуля. Когда на сайте было пять разборов, он не находился даже по точному заголовку статьи: поисковики о нём просто не знали.
Как я узнал, что ChatGPT выдаёт мой сайт в ответах?
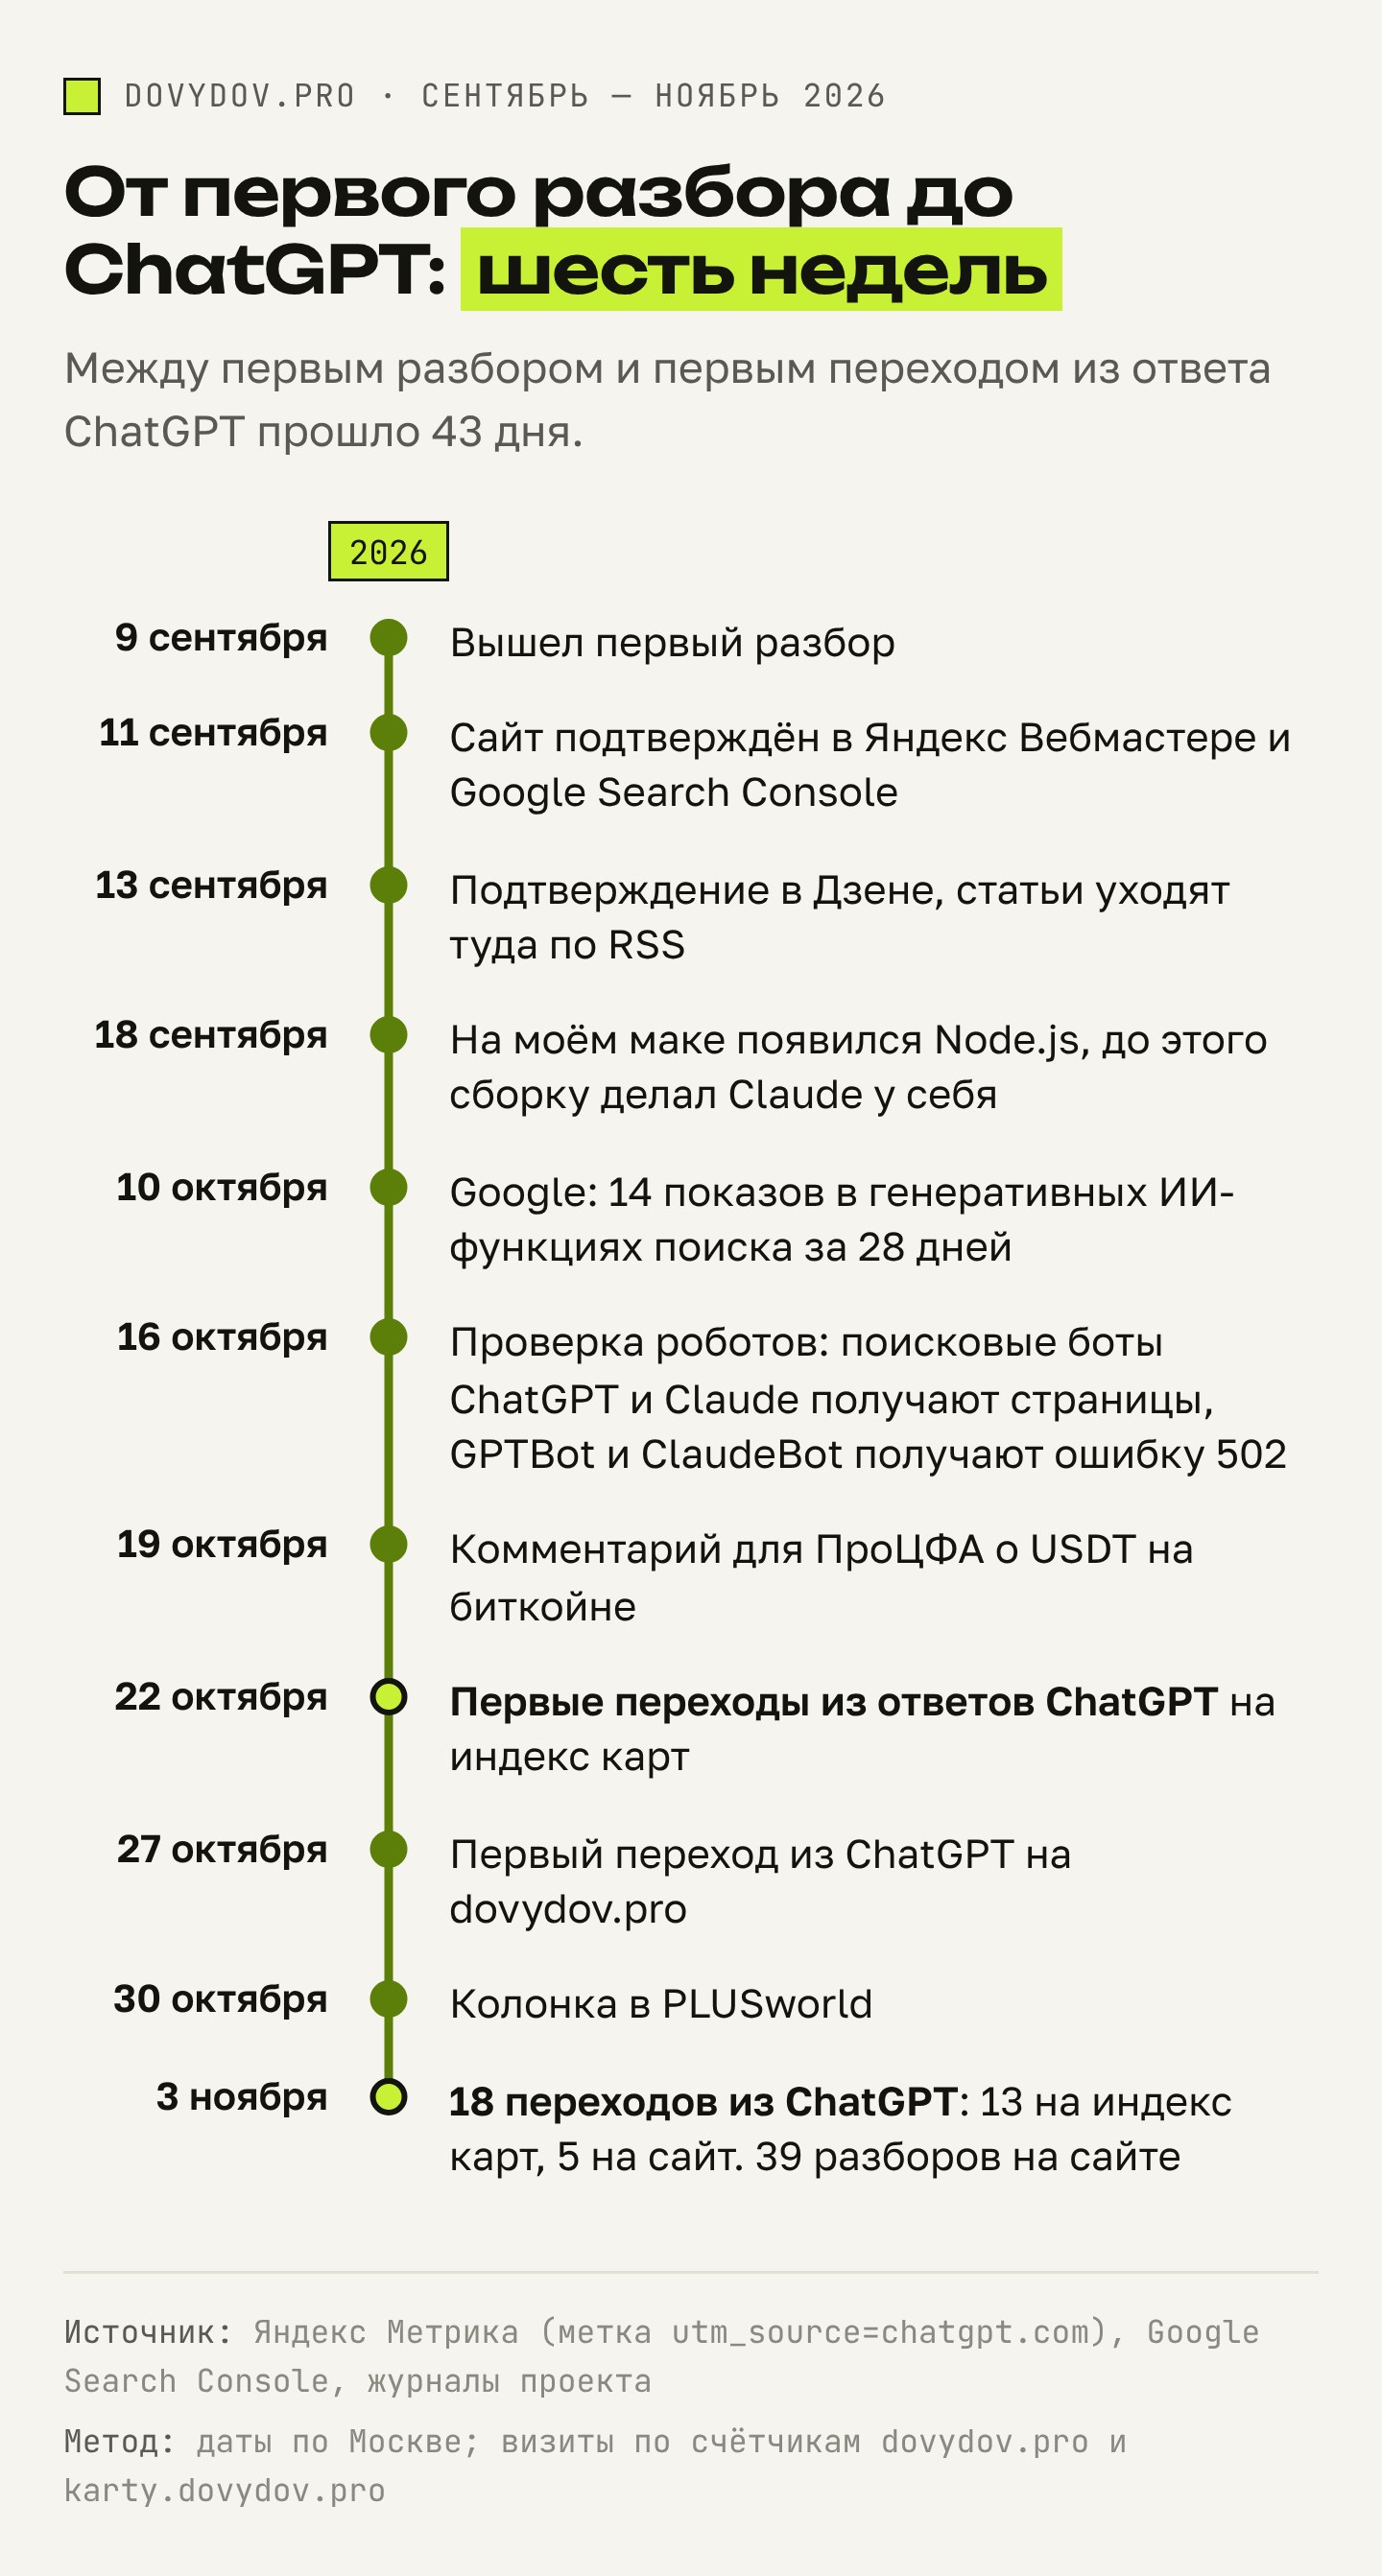
Первый измеримый сигнал пришёл от Google. В Search Console есть отчёт о показах в генеративных ИИ-функциях поиска, и за 28 дней по 10 октября у dovydov.pro их набралось 14, половина у разбора про карты в Казахстане. Сайту тогда был месяц.
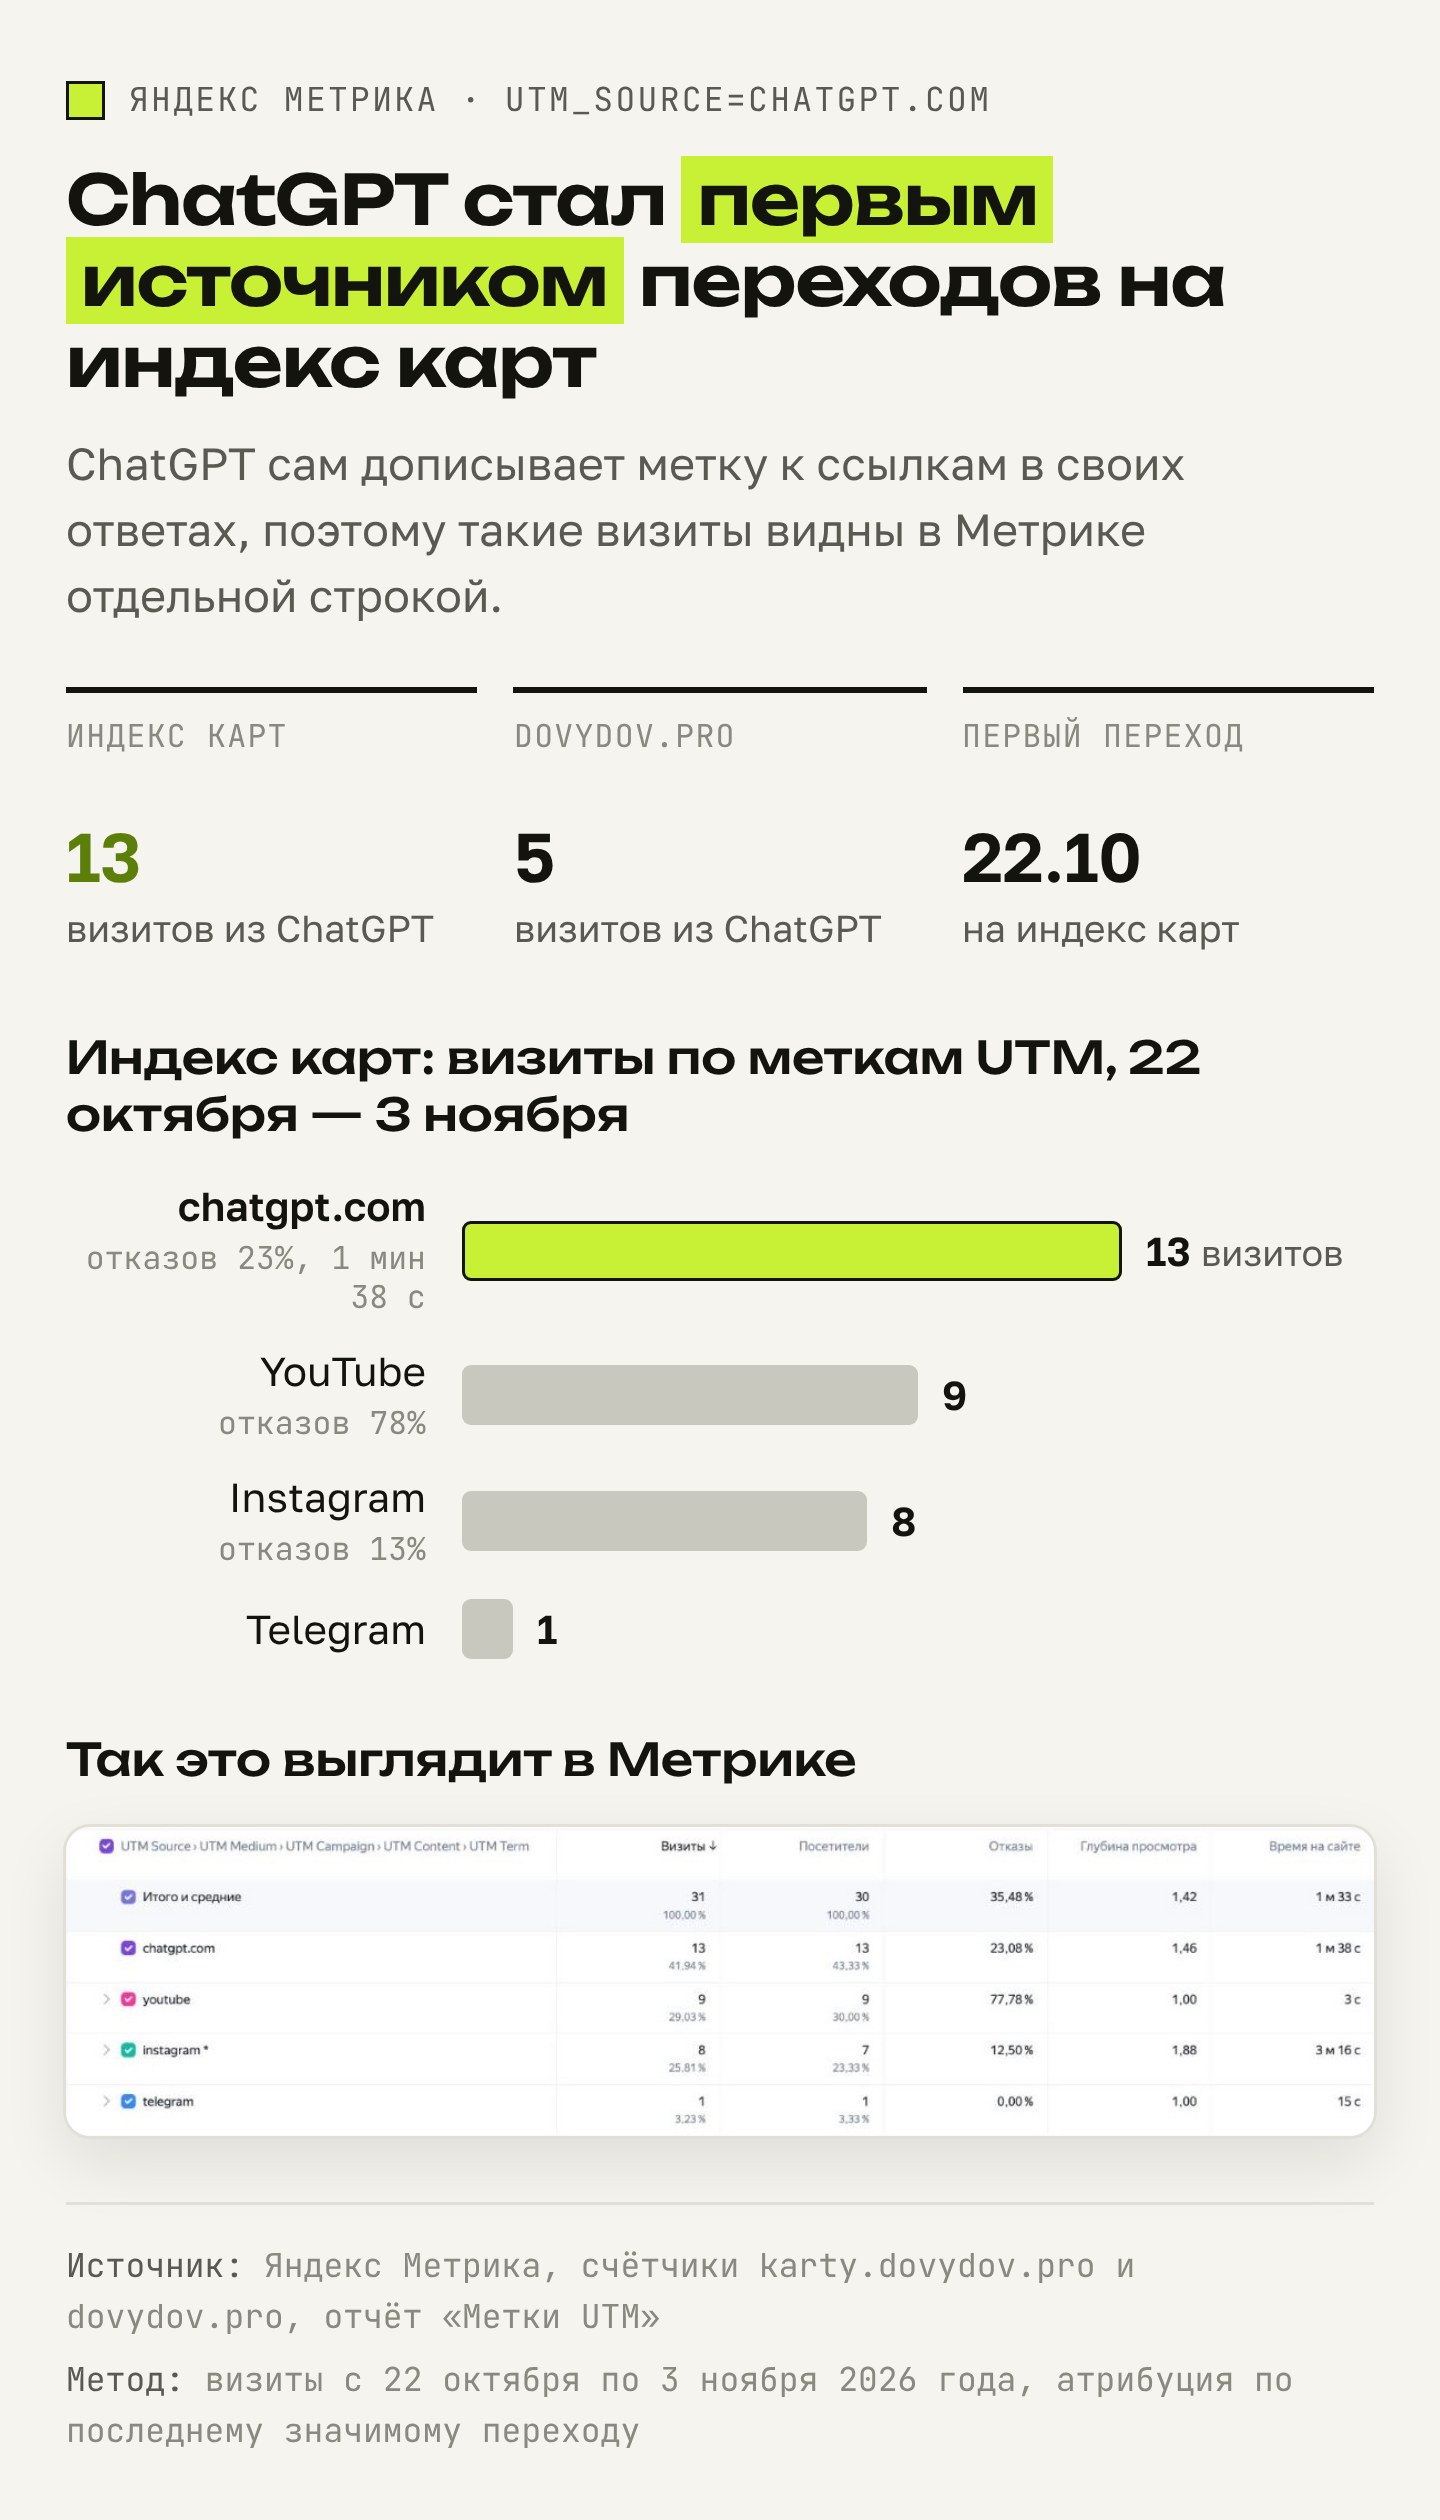
Про ChatGPT я узнал из Метрики, свой сайт у чат-бота я не спрашивал. Когда человек нажимает ссылку в ответе ChatGPT, тот сам дописывает к адресу метку utm_source=chatgpt.com, и в отчёте «Метки UTM» такой визит виден отдельной строкой. Раз в неделю Claude сводит эти переходы с другими признаками видимости в нейросетях в одну сводку.
Первые два перехода из ChatGPT пришли 22 октября на индекс карт, на dovydov.pro первый пришёл 27 октября. 1 ноября их было восемь за день: три на сайт и пять на индекс. С 22 октября по 3 ноября набралось 18 визитов, 13 на индекс карт и 5 на сайт. Сайту на момент первого перехода было шесть недель.
На индексе карт ChatGPT за эти дни стал первым среди размеченных источников: 13 визитов из 31, больше, чем по ссылкам из YouTube (9) или Instagram (8). Эти люди не уходят сразу: отказов 23%, на сайте в среднем полторы минуты.
Одному ответу чат-бота я не верю: ответы меняются от раза к разу, и удачный ответ на мой вопрос ничего не доказывает. Переход по метке надёжнее. Это живой человек, который получил ссылку на мой сайт в ответе и открыл её.
Что сильнее всего влияет на ответы нейросетей?
Работа на самом сайте даёт меньше, чем упоминания на других площадках. Модель охотнее ссылается на автора, чьё имя встречается в нескольких независимых источниках. Поэтому параллельно с сайтом я выхожу во внешние СМИ:
- 19 октября 2026 года ПроЦФА опубликовало мой комментарий как эксперта по регулированию цифровых активов в материале про USDT на биткойне;
- 30 октября в PLUSworld вышла моя колонка «Российский трансгран. Рынок, которого нет в статистике»;
- запросы журналистов я беру через Pressfeed, первый комментарий оттуда приняли к публикации в октябре;
- лонгриды выходят на VC.ru, а в Дзен статьи с сайта уходят по RSS со ссылкой на оригинал.
Все внешние публикации собраны на странице «Для СМИ», чтобы у модели и у журналиста была одна точка, где видно, кто я и где меня цитировали.
Как оплатить Claude из России?
Подписку Claude российской картой не оплатить, нужна зарубежная. У меня для этого валютная карта Алтына, на неё я перевожу рубли по СБП и с неё же оплачиваю Higgsfield. Тарифы Claude и Claude Code и что ещё понадобится при оплате, собрано в отдельной инструкции:
Частые вопросы
Нужно ли уметь программировать, чтобы сделать сайт через Claude?
Нет. Я не программист, весь код dovydov.pro написал Claude. От меня требовалось ставить задачи и проверять результат, а потом разобраться, как самому запускать сборку и заливку. До 18 сентября 2026 года на моём компьютере даже не было Node.js, и сборку делал сам Claude.
Почему не Tilda или другой конструктор?
Для выдачи в нейросетях нужно самому управлять разметкой Schema.org и служебными файлами вроде llms.txt и robots.txt. В коде любая такая правка делается один раз на весь сайт.
Что такое llms.txt?
Это файл в корне сайта с короткой картой сайта в Markdown для языковых моделей: автор, тема сайта и список материалов с краткими ответами. На dovydov.pro он собирается автоматически и содержит все опубликованные разборы с текстом блока «Коротко».
Как узнать, что ChatGPT ссылается на сайт?
Посмотреть в Яндекс Метрике отчёт «Метки UTM». ChatGPT дописывает к ссылкам в своих ответах метку utm_source=chatgpt.com, и переходы по ним видны отдельной строкой. У меня первые такие визиты пришли 22 октября 2026 года.
Гарантирует ли llms.txt попадание в ответы ChatGPT?
Нет. Как его учитывает ChatGPT, OpenAI не раскрывает. Сильнее работают понятная структура статей, разметка Schema.org, открытый доступ для роботов в robots.txt и упоминания автора на других площадках.
Пишет ли Claude тексты статей за меня?
Первоисточники ищет и сверяет Claude, он же пишет черновик. Тему и выводы выбираю я, и каждую статью перед публикацией правлю сам.
Материал носит информационный характер и не является инвестиционной или юридической рекомендацией.